2013-07-28

Play 2.x で sbt.ResolveException が発生する問題への対処

Play 2.x で開発していたアプリケーションをステージング環境で play run したり、プロダクション環境で稼動させるために play dist したときに、以下のように、sbt.ResolveException の例外が発生した旨のログ出力がされて異常終了してしまったときの対処法をメモっておきます。

[warn] some of the dependencies were not recompiled properly, so classloader is not avaialable
[info] Updating {file:/path/to/play-app/}play-app...
[warn]  [NOT FOUND  ] org.slf4j#slf4j-api;1.6.6!slf4j-api.jar (1ms)                    
[warn] ==== local: tried
[warn]   /opt/playframework/repository/local/org.slf4j/slf4j-api/1.6.6/jars/slf4j-api.jar
[warn]  ::::::::::::::::::::::::::::::::::::::::::::::
[warn]  ::              FAILED DOWNLOADS            ::
[warn]  :: ^ see resolution messages for details  ^ ::
[warn]  ::::::::::::::::::::::::::::::::::::::::::::::
[warn]  :: org.slf4j#slf4j-api;1.6.6!slf4j-api.jar
[warn]  ::::::::::::::::::::::::::::::::::::::::::::::
sbt.ResolveException: download failed: org.slf4j#slf4j-api;1.6.6!slf4j-api.jar
        at sbt.IvyActions$.sbt$IvyActions$$resolve(IvyActions.scala:214)
            (略)
        at java.lang.Thread.run(Thread.java:724)
[error] (*:update) sbt.ResolveException: download failed: org.slf4j#slf4j-api;1.6.6!slf4j-api.jar

原因

Play プロジェクトを構築した時の Play framework のバージョンと、play run などをしようとしたときのバージョンが異なる場合にこの例外が発生するようです。

より具体的には、Play プロジェクトが利用する sbt-plugin のバージョンは、実行環境の Play のバージョンと合わせる必要がある、ということです。

実は play run を実行したときに、実行直後のログに赤文字で

This project uses Play 2.1.1!
Update the Play sbt-plugin version to 2.1.2 (usually in project/plugins.sbt)

と出力されていたりします。どうしても例外ログの方に真っ先に目が行ってしまいがちですが、ちゃんと Play framework は警告してくれています。

対処法

project/plugins.sbt に記載されている sbt-plugin のバージョンを、実行環境の Play のバージョンと合わせましょう。例えば、Play プロジェクトを作成したときの Play のバージョンが 2.1.1 であれば、

addSbtPlugin("play" % "sbt-plugin" % "2.1.1")

となっているかと思いますが、これを、Play 2.1.2 の環境で稼動させようとするなら

addSbtPlugin("play" % "sbt-plugin" % "2.1.2")

としましょう。

19:54No comments

2013-06-29

第1回 #渋谷Java でトークしてきました

渋谷java という、渋谷界隈で Java やってる人達が集って LT するイベントが開催される、ということで (僕が勤めている仕事先は拠点が代々木ではありますが) 参加&お話をしてきました。

話した内容

元々は自社内で開催している「エンジニアリング勉強会」で展開した、Java アプリケーションを開発する際にパフォーマンス上注意すべき Tips を、外部向けに再構成してお話しました。ATND には「初心者向けレベルだとまだjavaを触って日が浅い主催者が泣いて喜びます。」と書いてあったので、初心者がやってしまいがちな、パフォーマンスを悪化させてしまうコーディングを中心にケーススタディとして挙げています (実際の参加者はガチ勢多数という感じでしたけどね!)。

再構成前の資料は5つぐらいのケーススタディを用いて 1 時間の説明をしていたのですが、今回は LT ということでページをバッサリと削って発表に臨みました。それでも、予定時間の 10 分より +6 分ぐらいオーバー、ということで時間内でしゃべりきるというのはやっぱり難しいなあ、と反省する次第です。

感想

以下、他の方のトークも含めた感想です。

  • Java の言語コミュニティなのに、ジャバ = エンタープライズ臭漂う残念めな言語、という認識の参加者が多いこと。
  • 仕事で Java 使っているからといっても Java が好き、というわけではない。Ruby が好きとか、仕方なく使っているとかそういう人もいる。
  • Play framework の認知度が高まってきている印象。Java で Play 2.x は微妙的な意見もあった (し、それを否定する気もさらさらない) けど、Java の世界でもっと流行ってくれるといいなー。
  • BizReach 社のセミナールーム (?)、オシャレですね!
  • 渋谷Java、今後も継続開催していただけることを期待してまーす!
18:12No comments

2013-06-19

Play! 2.0 / 2.1 ぐらいで play コマンドを実行したときに Permission denied な例外が発生する問題への対処

イラッとしたのでメモ。

概要

Linux など UNIX 系 OS に Play framework 本体をインストールし、${PLAY_HOME}/play コマンドで play clean compile stage などをした場合に、

java.io.FileNotFoundException: /path/to/play/framework/sbt/boot/sbt.boot.lock (Permission denied)
        at java.io.FileOutputStream.open(Native Method)

とか

java.io.FileNotFoundException: /path/to/play/repository/.sbt.ivy.lock (許可がありません)
        at java.io.FileOutputStream.open(Native Method)

などの Java の IOException が発生してしまうことがある件への暫定対処です。

原因

そもそも何でこの例外が発生するのかというと、Play framework 本体をインストールした際のユーザ (所有者) であったりパーミッションの設定が厳しかったりすることが原因となり、上記した類のロックファイルの作成や書き込みができないことによります。

※ play コマンドを実行したときに、${PLAY_HOME} ディレクトリ以下に書き込みをする Play framework もどうかと思いますがね…

(暫定) 対処法

本当はもうちょっとスマートな方法があるんじゃないか… と思ったのですが何かと面倒そうなので、

chmod -R go+wx ${PLAY_HOME}/framework/sbt/boot
chmod -R go+wx ${PLAY_HOME}/repository

こんな感じで解決するのがいいでしょう。

2013.8.21 追記

よくよく Play! 2.x の公式ドキュメント http://www.playframework.com/documentation/2.1.3/Installing を読んでみると、

Download the latest Play binary package (take the latest official version) and extract the archive to a location where you have both read and write access. (Running play writes some files to directories within the archive, so don’t install to /opt, /usr/local or anywhere else you’d need special permission to write to.)
と書かれていました。つまり「(ファイル/ディレクトリ書き込みなどをするから) /opt, /usr/local にはインストールするなボケ!」ということですね。

23:371 comment

2013-06-03

Jubatus Casual Talks #1 でトークしてきました #jubatuscasual

主催者の方に発表内容をかっちりと決めずになんとなく「発表したいです!」と参加表明してみたものの、いざ開催日が近づくと「やばいな発表できるネタができない…」という状態に陥ってちょっとお腹痛くなる思いをしましたが、何とか発表し切れてホッと一息ついたのでエントリ起こしておきます。

Jubatus って何?

PFI & NTT によって共同開発されている、「機械学習の各種タスクをオンライン (かつ分散) で処理できるようにする」ことを目的としたプロダクトです。「機械学習」と一口に言ってもいろいろありますが、例えば「クラス分類」とか「回帰」とか「レコメンド」とかが Jubatus ではできるようですね。

詳しくは 公式 をご覧ください。

お話したこと

「Java で楽して Jubatus したい!」というタイトルで、Java から Jubatus を利用する際にお世話になる Jubatus Java Client に関してお話をしました。

他の方々の発表は軒並み「Jubatus を使って◯◯しました」というとっても実践的な内容、というか ガチュアルな内容も盛りだくさんで、Jubatus を使わないネタで発表をする身としては肩身が狭いことこの上ありませんでしたが、まあ多少盛り上がった (?) ようでしたのでよしとしましょう…

発表内容は以下のスライドをご覧いただくとして、ざっくり要約すると

  • Java から Jubatus を使ってみようかなー
  • Jubatus Java Client を使う必要があるらしいけど… こ、これを使うのははちょっと辛いな…
  • よし、楽に使えるラッパーライブラリを作ろう → Jubaba (ゆばーば) 爆誕!

こんな感じです。


Jubaba (ゆばーば)

そういうわけで、Java から Jubatus をカジュアルに利用するためのラッパーライブラリ、 Jubaba プロトタイプ版を作り始めました!

まだまだインタフェースも試行錯誤を重ねていて流動的だったり、多値分類 (Classifier) しかサポートできていないので完成には程遠い状態ですが、ちょっとずつ開発を進めていく予定です。ご要望、ご意見等ありましたらご連絡いただけると幸いです。あ、pull request くれてもよかですよ!!

その他・感想

発表機会をくださいました @unnonouno さんこと海野さん、Jubatus 関係者の方々、そして拙い発表を忍耐強く聞いてくださった会場参加者の方々、ありがとうございました!

  • Jubatus 開発チームの、Java に対する如何ともし難い黒いオーラが滲み出ているところを深くえぐってしまった (※後述) 感がありますねこの発表は… ははは。ごめんなさい…
    • 懇親会のときの、海野先生のコード生成裏話 LT は涙なしには聞けなかったです、はい。
  • Java で機械学習している人、前からわかっていたことですが少ないですねー。Java エンジニアとしては、もっと盛り上げていきたいなあ。
    • 今回の開催でも、他の参加者はみんな Python だったり Ruby を使ってるし、それらとの対比で Java での煩わしさを引き合いに出されるし… 特徴抽出を試行錯誤するなら LL な言語でやるのが定石ですね。
  • 異常検知、熱いですね! このみなさんの注目度は意外だったー。

そんなわけで、また機会がありましたらお邪魔させてください&ネタがありましたら発表させてください! (今度はガチュアルな話をしたい…)


※補足

えぐってはいけないものをえぐってしまってごめんなさいごめんなさいごめんなさい…
9:03No comments

2013-05-20

Java 7 時代の String#split() 事情

Java 7 になって String#split() の実装が変更されたことに今更ながら気付いたので、Pattern#split() や Java 6 との性能の比較をしてみたメモです。

Java 6 以前の文字列分割処理

古くから Java を触っているエンジニアであればみな当然知っていることだと思いますが、 TSV ファイルを Java のプログラムで読み込んで処理をするときなど、特定のデリミタで区切られた文字列を個々の要素に分割するときは String#split() を利用せず、事前にデリミタに対する java.util.regex.Pattern オブジェクトを生成しておき、そのオブジェクトを使い回す形で Pattern#split() を利用した方が処理効率 (処理時間) がよくなります。

これは、 String#split() の実装が実質的に Pattern.compile(delimiter).split(str) と等価であることによります。つまり String#split() メソッドは、そのメソッドの呼び出し毎に Pattern オブジェクトを生成するため、オブジェクト生成のオーバーヘッド (と GC 発生頻度の増加) によって処理性能が悪化する、ということです。

Java 7 での String#split() 実装

一方で、Java 7 ではこの String#split() に手が加えられ、Java 6 以前と少し事情が異なっています。

public String[] split(String regex, int limit) {
    /* fastpath if the regex is a
     (1)one-char String and this character is not one of the
        RegEx's meta characters ".$|()[{^?*+\\", or
     (2)two-char String and the first char is the backslash and
        the second is not the ascii digit or ascii letter.
     */

上記は Oracle 社の JDK 1.7 src.zip に含まれる String.java より拝借してきた String#split() のメソッド冒頭のコメントです。

この英語をざっくり翻訳すると『指定された正規表現が次の 2 つのどちらか

  • 1 文字で構成されていて、正規表現におけるメタ文字 ".$|()[{^?*+\\" のいずれでもない
  • 2 文字で構成されていて 1 文字目がバックスラッシュ、2 文字目が 英数字以外 である

に合致する場合に、より手短に済む処理をする』となります。

これはつまり「実質的に特定 1 文字の正規表現として取り扱える場合は、(Pattern#split()) より高速な文字列分割処理できる」ことを意味しています。事実、上記コメント以降の String#split() 実装を見てもらえるとわかりますが、 Pattern オブジェクトを生成することなく、 String#indexOf() を用いた単純な文字探索ベースでの文字列分割を実現しています。

ところで Java エンジニアとしては、この Java 7 での変更により、どの程度性能に影響が現れるのかが気になるところです。そういうわけで、

  • Java 6 での String#split() と Pattern#split()
  • Java 7 での String#split() と Pattern#split()

それぞれの処理性能を比較してみることにしました。

文字列分割処理の性能比較

性能比較は こちらのデモプログラム を用いて実施しました。

結果は こちらの Google ドキュメント にまとめました。

結果を見ると明らかですが、Java 7 で特定の 1 文字を現す正規表現 (" ") を指定した場合は String#split() の方が Pattern#split() よりも 2 倍以上速くなっています。一方で、複数種類の文字に一致する正規表現 ("\s") を指定した場合は、Java 6 と同じ傾向になっていることがわかります。

Google ドキュメントには正規表現を複雑にしたときの性能比較と、ガベージコレクションの発生回数も参考までに掲載しておきました。この結果より、

  • Java 6 → Java 7 では、 Pattern クラスの各種処理性能が若干劣化している?
  • 正規表現を複雑にすると String#split() 側の性能が劣化する (= Pattern.compile() の処理のオーバーヘッドが効いてくる)
  • 選択の正規表現は (Pattern.compile() もそうだけど) マッチング処理がとにかく重い

ということが窺えますね。

まとめ

今回のまとめは以下のとおり。

  • Java 7 以降なら、TSV ファイルの 1 行を分割するなど、特定の 1 文字で構成されたデリミタを指定するときは迷わず String#split() しよう
  • Java 6、もしくは複数文字や複雑な正規表現で分割したい場合は、 Pattern オブジェクトを事前に定数的に生成しておき、使いまわして Pattern#split() しよう
11:49No comments

2013-03-29

Java の BlockingQueue 実装の性能を比較してみた

巷では「ArrayBlockingQueue よりも LinkedBlockingQueue の方がスループット性能がいいよ」なんてまことしやかに言われているけど、どうにも気になったので検証してみたら、実は ArrayBlockingQueue の方が性能いいんじゃない? という結論に至った話です。

Producer-Consumer デザインパターンと BlockingQueue

Java で Producer-Consumer デザインパターン を実現するときによくお世話になる BlockingQueue インタフェース。このインタフェースには ArrayBlockingQueue クラス と LinkedBlockingQueue クラス の二つの実装が標準 API として提供されています。

高い処理性能を要求されるプログラムを Java で書こうとしたときに、CPU のすべてのコアをフル稼動させることを狙って Producer-Consumer パターンによって処理フローをパイプライン的に構成することがあります。そのときにいつも気になっていたのが、「ArrayBlockingQueue と LinkedBlockingQueue、果たしてどちらを利用した方がスループットが高くなるのだろうか?」ということ。

この疑問に対して、海外でも 議論 されていたり、検証 されていたりされているようで、それらの 結論 としては概ね「LinkedBlockingQueue の方が ArrayBlockingQueue よりも高スループットだよ」というものになっています。

しかし、ArrayBlockingQueue と LinkedBlockingQueue の双方の実装やデータ構造の特性を考えると「LinkedBlockingQueue の方が高スループット」という結論がにわかに信じ難かったので、実際に検証をしてみることにしました。

双方のデータ構造と実装の特性

検証を始める前にまず、それぞれのデータ構造および実装の特性を確認してみることにします。参考にした実装は Oracle の JDK 1.7 (update 17) です。

ArrayBlockingQueue クラス

  • 配列をベースとしたキュー実装で、配列をリングバッファとして扱います。
    • エンキュー (add() / offer() / put()) 操作、デキュー (remove() / poll() / take()) 操作をする配列上のインデックスを、それぞれ別々に保持しています (putIndex フィールドと takeIndex フィールド)。
  • キューの大きさは固定長で、その大きさを超える要素数を保持することはできません。
  • エンキュー操作において、余計なオブジェクトが生成されることはありません。
  • エンキュー/デキュー操作では、一つのロックオブジェクト (lock フィールドの ReentrantLock オブジェクト) を共用して排他制御をします。
    • エンキューとデキュー操作のメソッド呼び出しが重なると、一方の処理にてロック解除待ちが生じてしまいます。

LinkedBlockingQueue クラス

  • 片方向の連結リストをベースとしたキュー実装です。
    • 要素の数に応じて、リストが伸長・縮退します。
  • 連結リストの先頭 (head フィールド) より要素をデキューし、末尾 (last フィールド) に要素をエンキューします。
  • 保持できる要素数は最大で Integer.MAX_VALUE になります。
    • コンストラクタで capacity を指定することで、保持する要素数を制限することもできます。
  • 要素のエンキュー操作ごとに、連結リストの Node オブジェクトの生成操作が発生します。
    • 1 つの要素につき 16 バイトほどのヒープを余計に消費します。
  • エンキュー/デキュー操作の排他制御はそれぞれ別々のロックオブジェクト (putLock フィールド、takeLock フィールド) を利用します。
    • エンキューとデキュー操作のメソッド呼び出しが重なったとしても、ロック解除待ちは発生せず並列に処理することができます。

これら上記の双方の特性を比較すると、

  • ArrayBlockingQueue は処理が単純な分、エンキュー/デキュー操作の処理コストが小さく、一方で LinkedBlockingQueue はオブジェクト生成が必要となるために特にエンキュー操作の処理コストが高い。
  • ArrayBlockingQueue は、エンキュー/デキュー操作においてロックオブジェクトを共有するために Producer / Consumer の並列性が低くなるが、LinkedBlockingQueue は別々のロックオブジェクトが用意されているため、Producer / Consumer の並列性が高まる。

と言うことができそうです。 LinkedBlockingQueue の方がスループットが高い、というのは後者の並列性が根拠になっていると思われますね。

性能検証する

続いて、実際に両者の BlockingQueue 実装を利用したプログラムを作成し、各種性能を測定してみました。

測定方法

検証用プログラム を用いて、エンキュー操作、デキュー操作を独立して 1,600 万回ほど行ったときの処理時間、およびエンキュー/デキュー操作を複数の別スレッド (Producer / Consumer) で同時並列に 1,600 万回実施したときのスループットを ArrayBlockingQueue, LinkedBlockingQueue それぞれの実装ごとに測定してみました。

また測定を進めていく上で、Java VM の 32 bit と 64 bit の違いや、Java コンパイラ (JDK / Eclipse)、ハードウェア・OS (Windows / Mac) の違いが性能に影響を与えることが明らかになったため、これらの構成の組み合わせも合わせて検証してみることにしました。

検証環境

  • ハードウェア・OS
    • Windows PC
      • Windows 7 (64 bit)
      • Core i5-3450 (3.10GHz)
      • 8GB Memory
    • Mac
      • Mac OS X 10.8.2
      • 1.7GHz Core i5-3317U
      • 4GB Memory
  • Java
    • Java VM (オプション : Xms1200m)
      • Java 7 Update 17 (32 bit & 64 bit)
    • Java コンパイラ
      • JDK 1.7 Update 17
      • Eclipse Compiler for Java 3.8.2

測定項目

  • エンキュー/デキュー操作を行う各種メソッドの呼び出しにかかる時間 [ミリ秒]
    • エンキュー
      • add()
      • offer()
      • put()
    • デキュー
      • remove()
      • poll()
      • take()
  • スループット [メッセージ/秒]
    • Producer x 1 スレッド, Consumer x 1 スレッド
    • Producer x 1 スレッド, Consumer x 2 スレッド
    • Producer x 2 スレッド, Consumer x 1 スレッド
    • Producer x 2 スレッド, Consumer x 2 スレッド

測定結果と考察

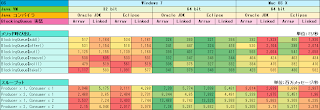
上記の内容で測定した結果を Google ドキュメントで公開 しています。数値に対するカラースケールは行(横一列)のグループに対して設定されており、緑色が良い性能であることを、黄色がほどほどの性能を、赤色が性能が悪いことを示します。

Java VM (64 bit / 32 bit) の違い

さてこの結果を見てすぐに分かることは、ArrayBlockingQueue と LinkedBlockingQueue のどちらについても、32 bit Java VM よりも 64 bit の方が性能がよい、ということになりますね。メソッド単体の呼び出し性能もスループットも、どちらも下は 1.5x から上は 4x ぐらいまでの性能が 64 bit VM では出ています。

メソッドの呼び出し性能に着目すると、32 bit VM ではメソッド間で性能差が大きく開きバラつきがあり、ArrayBlockingQueue も LinkedBlockingQueue もそれぞれの性能特徴がよく分かる結果となっています。一方で 64 bit VM では、メソッド間の性能差は 32 bit ほどの開きは見られず、安定した性能が出せていることがうかがえます。

スループットについては、64 bit VM を使うことで ArrayBlockingQueue の性能が 32 bit VM のときより大幅に性能向上することが見て取れます。LinkedBlockingQueue も 64 bit VM による性能劣化はなく、ArrayBlockingQueue ほどではないものの多少の性能向上がうかがえます。

Java VM の違いにおいて ArrayBlockingQueue と LinkedBlockingQueue の結果を比較すると、

  • 32 bit VM では LinkedBlockingQueue の方が性能がよい。
  • 64 bit VM では ArrayBlockingQueue の方が性能がよい。

と言えるでしょう。

Java コンパイラ (JDK / Eclipse) の違い

コンパイラの違いについては、今回の測定結果では優劣が明確になるほどの性能差は出ませんでした。

ハードウェア・OS の違い

Mac の場合、ArrayBlockingQueue と比べて LinkedBlockingQueue の性能が全体的に悪いことがわかります。メソッドの呼び出しについては、特にエンキュー操作の性能が極端に悪いですね。

スループットも、エンキュー操作メソッドの性能に引きづられてか、LinkedBlockingQueue の性能は芳しくありません。エンキュー操作が競合しやすい Producer x 2 の構成での落ち込みが大きいですね。

Mac では、 ArrayBlockingQueue 択一 と言ってしまっていいと思います。

まとめ

ArrayBlockingQueue を使うべきか、それとも LinkedBlockingQueue を使うべきかの判断は Java VM 次第、すなわち

  • (Mac を含む) 64 bit の Java VM を利用するなら ArrayBlockingQueue がよい。
  • 32 bit の Java VM なら LinkedBlockingQueue がよい。

と言ってしまっていいでしょう。ただ今後のことを考えれば 64 bit VM の利用が多くなっていくと考えられるため、開発時点では 32 bit の VM 利用を想定していても、ArrayBlockingQueue を採用しておくのが無難じゃないかと思います。はい。

だいじなこと

今回は Windows と Mac とで性能検証をしてきたのですが、実際に Java アプリが利用される環境は Linux など Unix 系の OS が多いかと思います。今回の検証でなんとなく傾向はつかめた (64 bit なら ArrayBlockingQueue) のですが、これがそのまま Linux でも通じるかどうかはまた別の話、つまりは要検証、ということです。

2:22168 comments